Caso de estudio · 2024—25
Benchmarks AI
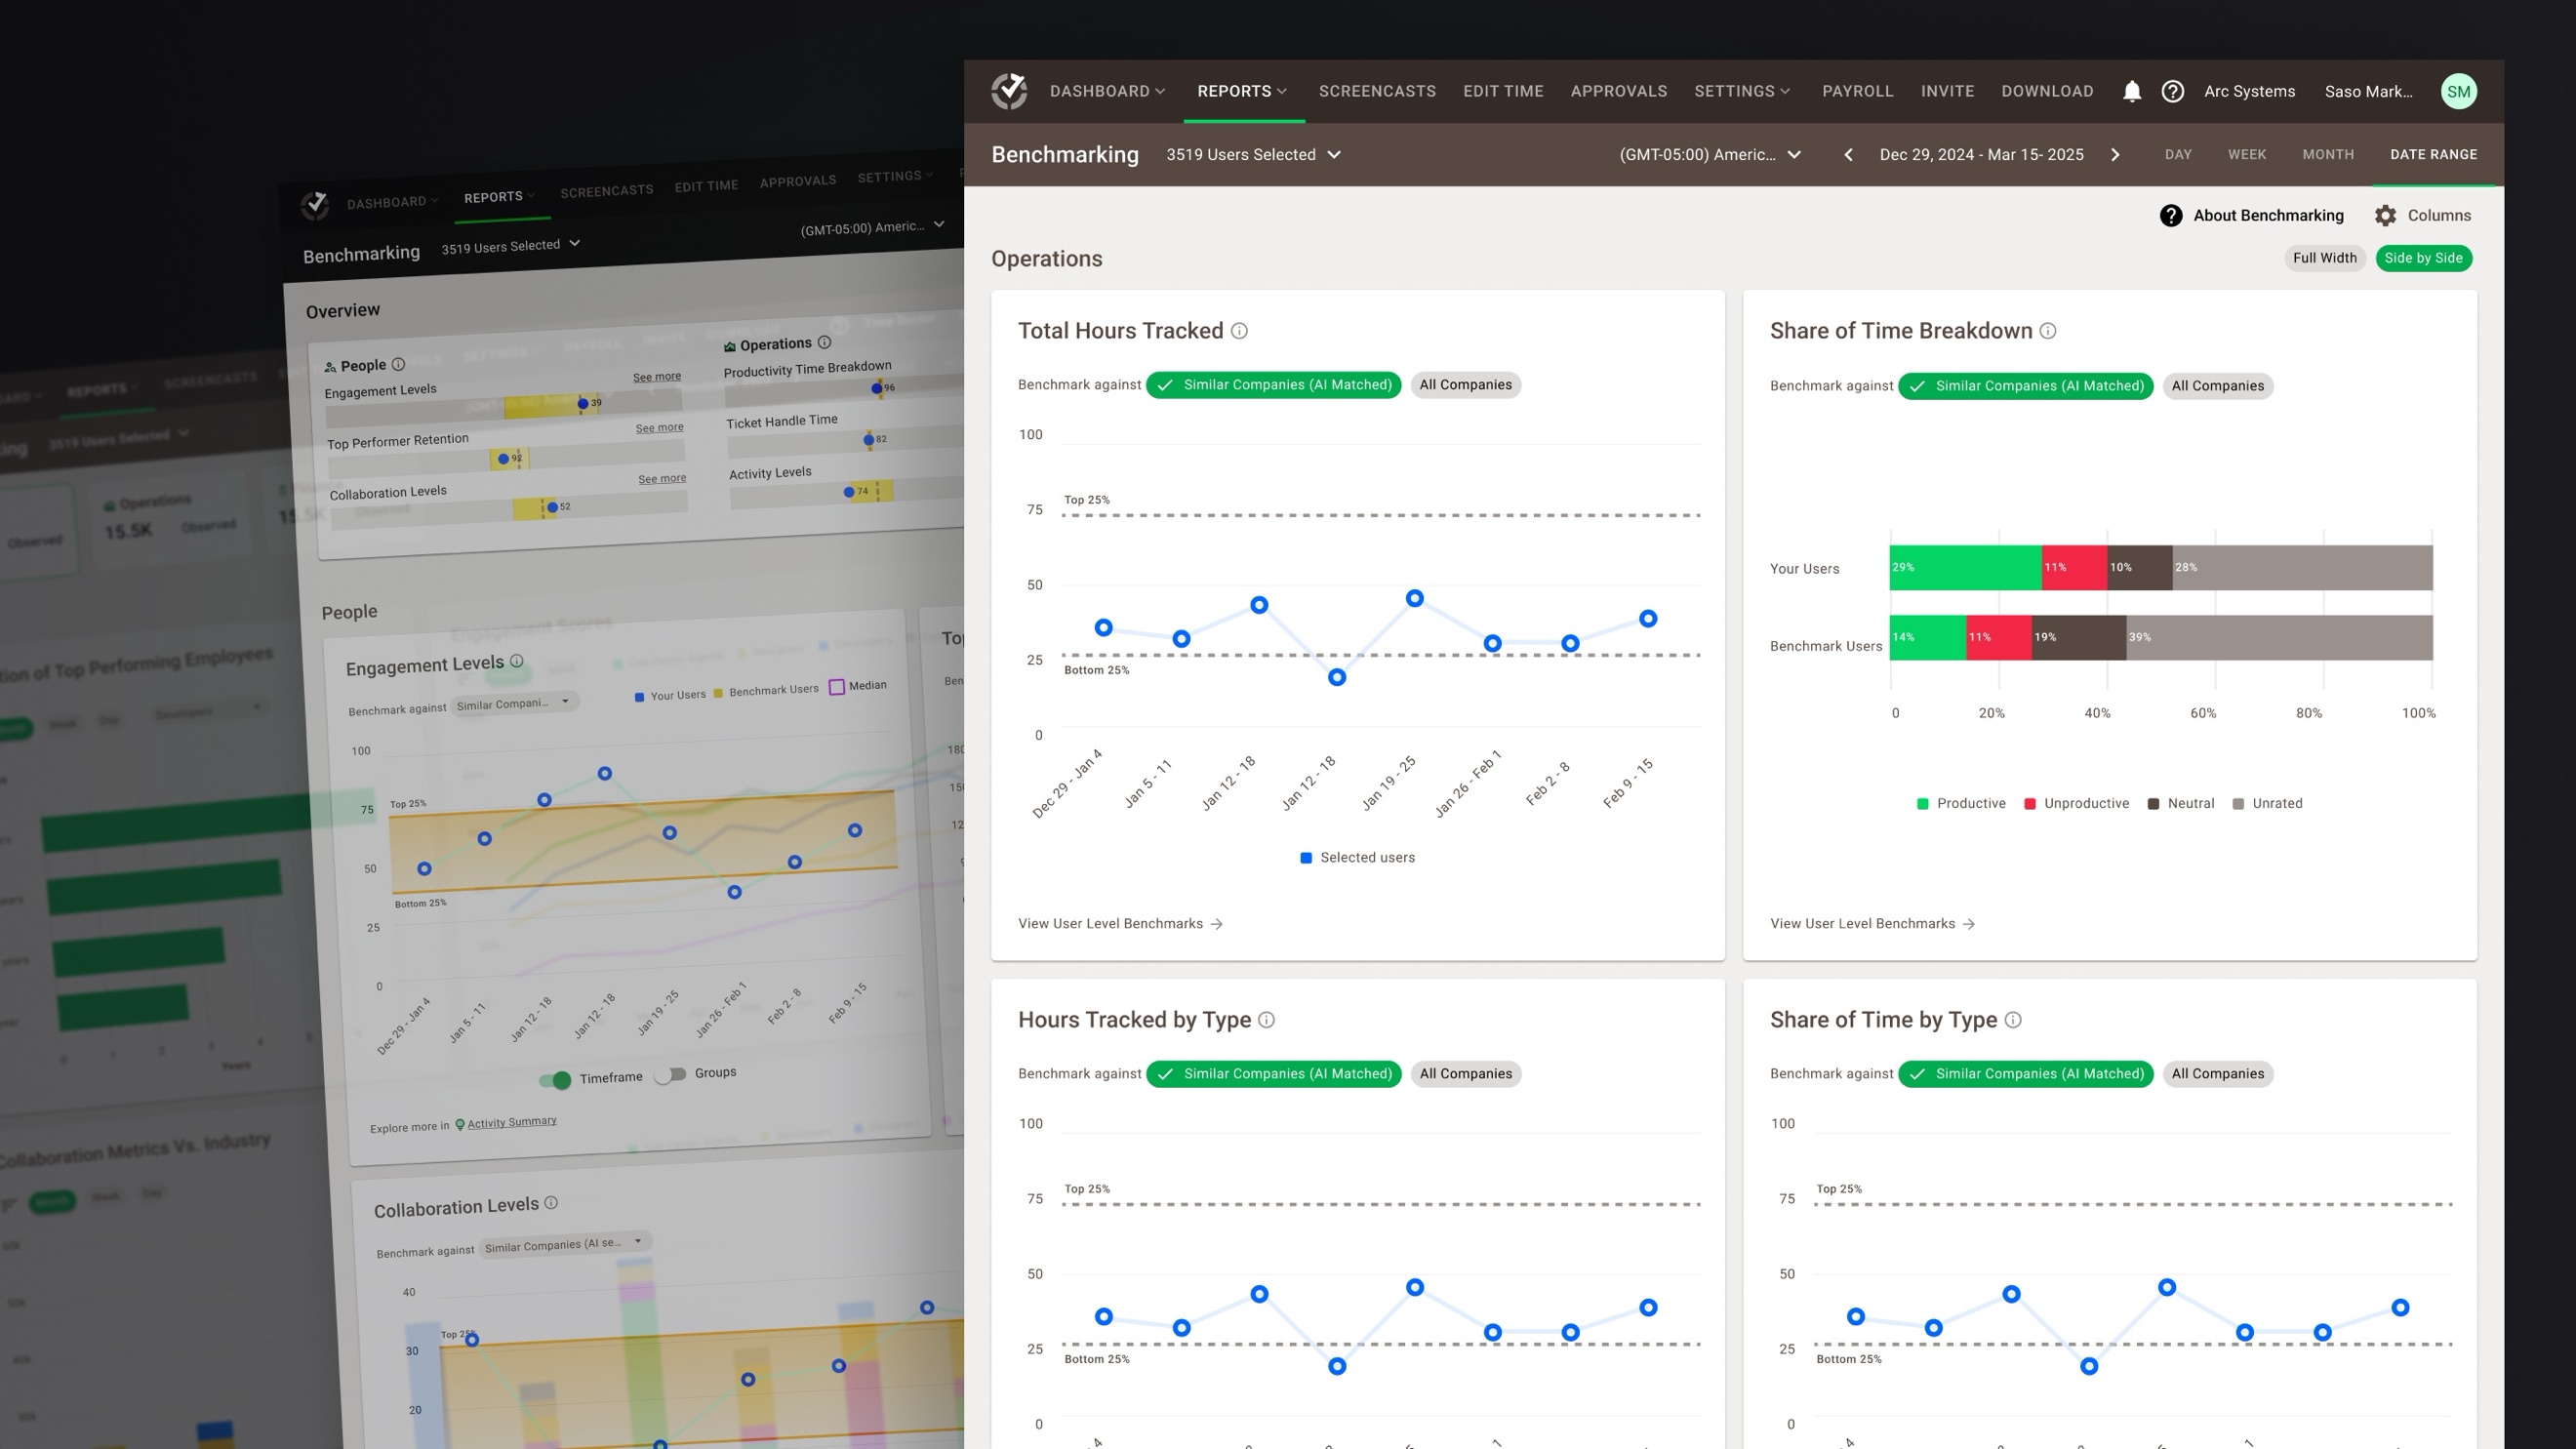
Los gerentes de Time Doctor podían ver las cifras de su equipo, pero no tenían con qué compararlas. Benchmarks AI empareja a una empresa con organizaciones que realmente se comportan como ella, de modo que un gerente puede saber si una cifra es buena y no solo cuál es.
01 · El desafío
Los gerentes tenían muchos datos. Lo que no tenían era contexto sobre cómo se ve lo «bueno».
Benchmarks AI permite a un equipo ver cómo se comparan sus patrones de trabajo con los de empresas similares, usando datos anonimizados agrupados de toda la base de clientes — un chequeo de salud de cómo trabaja tu equipo frente a sus pares.
Así es como un gerente encuentra una brecha que vale la pena mirar, comprueba un supuesto antes de actuar y abre una conversación sobre desempeño con algo más que una corazonada.
Las métricas nunca fueron la pieza que faltaba. Los datos de actividad y de seguimiento del tiempo ya existían. Lo que faltaba era un punto de referencia externo, y sin uno, leer una métrica de desempeño podía reducirse fácilmente a sesgo o a conjeturas.
Así que el producto agrega contexto relativo en lugar de otra capa de datos en bruto: el desempeño entendido por comparación y no de forma aislada, tanto para una persona como para el equipo que la rodea.
Por qué importa
- Abre la puerta a un asesor que pueda señalar anomalías, sugerir cambios de proceso y destacar por sí solo a las personas de mejor desempeño.
- Le da al resto del ecosistema de Time Doctor un marco sobre el cual construir otros insights impulsados por IA.
02 · Investigación
Antes de diseñar la solución, probamos si el problema valía la pena.
Partimos de hipótesis sobre lo que los gerentes podrían querer y, en vez de discutirlas, las pusimos a prueba — un experimento de puerta pintada construido directamente en el producto.
El interés se disparó. Así que seguimos:
- Entrevistamos a early adopters y a colaboradores internos.
- Pusimos visuales de concepto rápidos frente a las personas, construidos con métricas reales y no con números de relleno.
- Hicimos pruebas de usabilidad no moderadas con no usuarios en Useberry y Lyssna.
- Hicimos seguimiento con sesiones moderadas sobre prototipos funcionales dentro de Time Doctor.
Hacerlo tan liviano era la idea. Nos dijo qué valoraba realmente la gente lo bastante temprano como para que recortar el resto costara casi nada.
Hallazgo clave
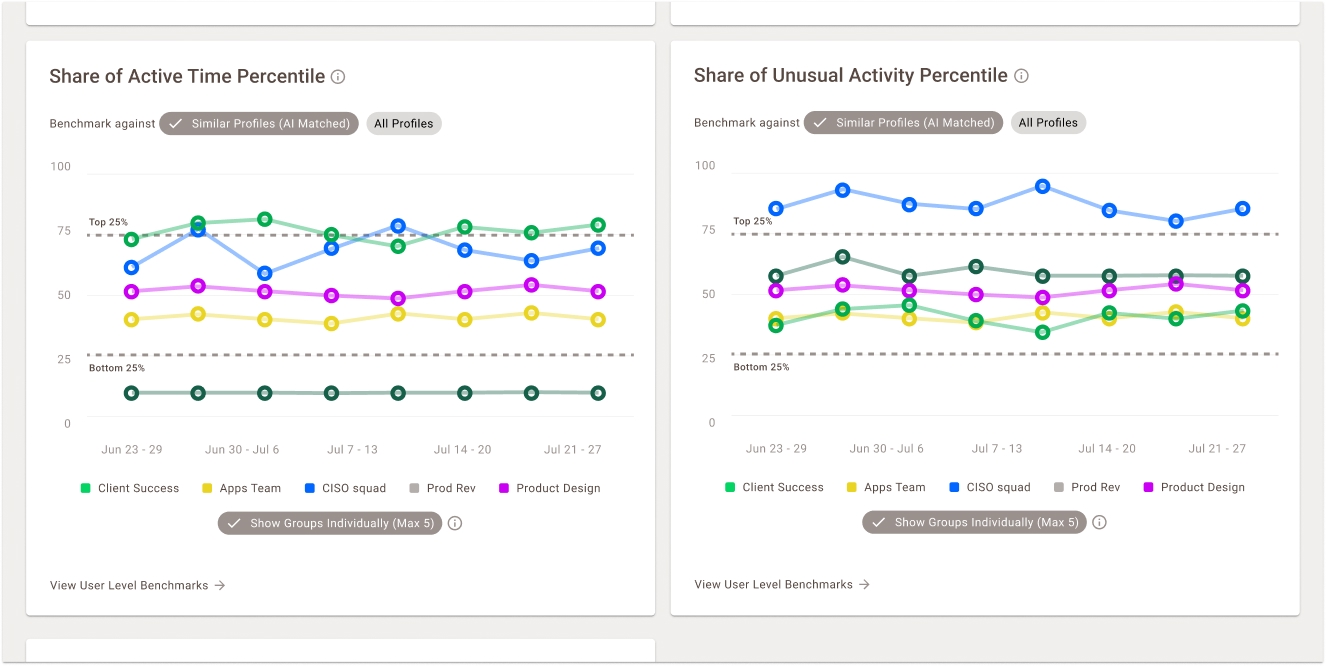
Colocar métricas relacionadas lado a lado — Share of Active Time Percentile junto a Share of Unusual Activity Percentile — creó una claridad narrativa inmediata. Los gerentes podían detectar correlaciones e iniciar conversaciones sin necesitar explicación adicional.
Poco tiempo activo con mucha actividad inusual es el ejemplo más claro: leídos juntos, el par puede apuntar a trabajo fingido — esfuerzo que parece ocupado sin producir mucho. Ninguno de los dos números lo sugiere por sí solo. Antes de Benchmarks AI, armar esa historia significaba sacar reportes separados a mano y saber ya qué buscar.
03 · Diseño
El benchmark no se basa en lo que una empresa dice ser. Se basa en cómo se comporta realmente su fuerza laboral.
Las empresas se emparejan por similitud de comportamiento y no por industria o rol autodeclarados, lo que hace la comparación mucho más precisa que la etiqueta que un cliente escribió al registrarse.
Estructura de la experiencia
- Un dashboard de tarjetas de métricas, cada una un gráfico de líneas que compara la fuerza laboral del cliente con benchmarks de comportamiento anonimizados.
- Cada gráfico abarca varias semanas y abre un panel lateral con el detalle semana a semana.
Lo difícil
- Mostrar datos densos sin enterrar a la persona que los lee.
- Dar el nivel de visibilidad correcto a cada rol, desde propietarios hasta RR. HH. y líderes de equipo.
- Encontrar un ritmo entre los gráficos para que la página se pudiera escanear en vez de estudiar.
- Encajar nuevos patrones de visualización en las convenciones de UI existentes de Time Doctor.
Validación
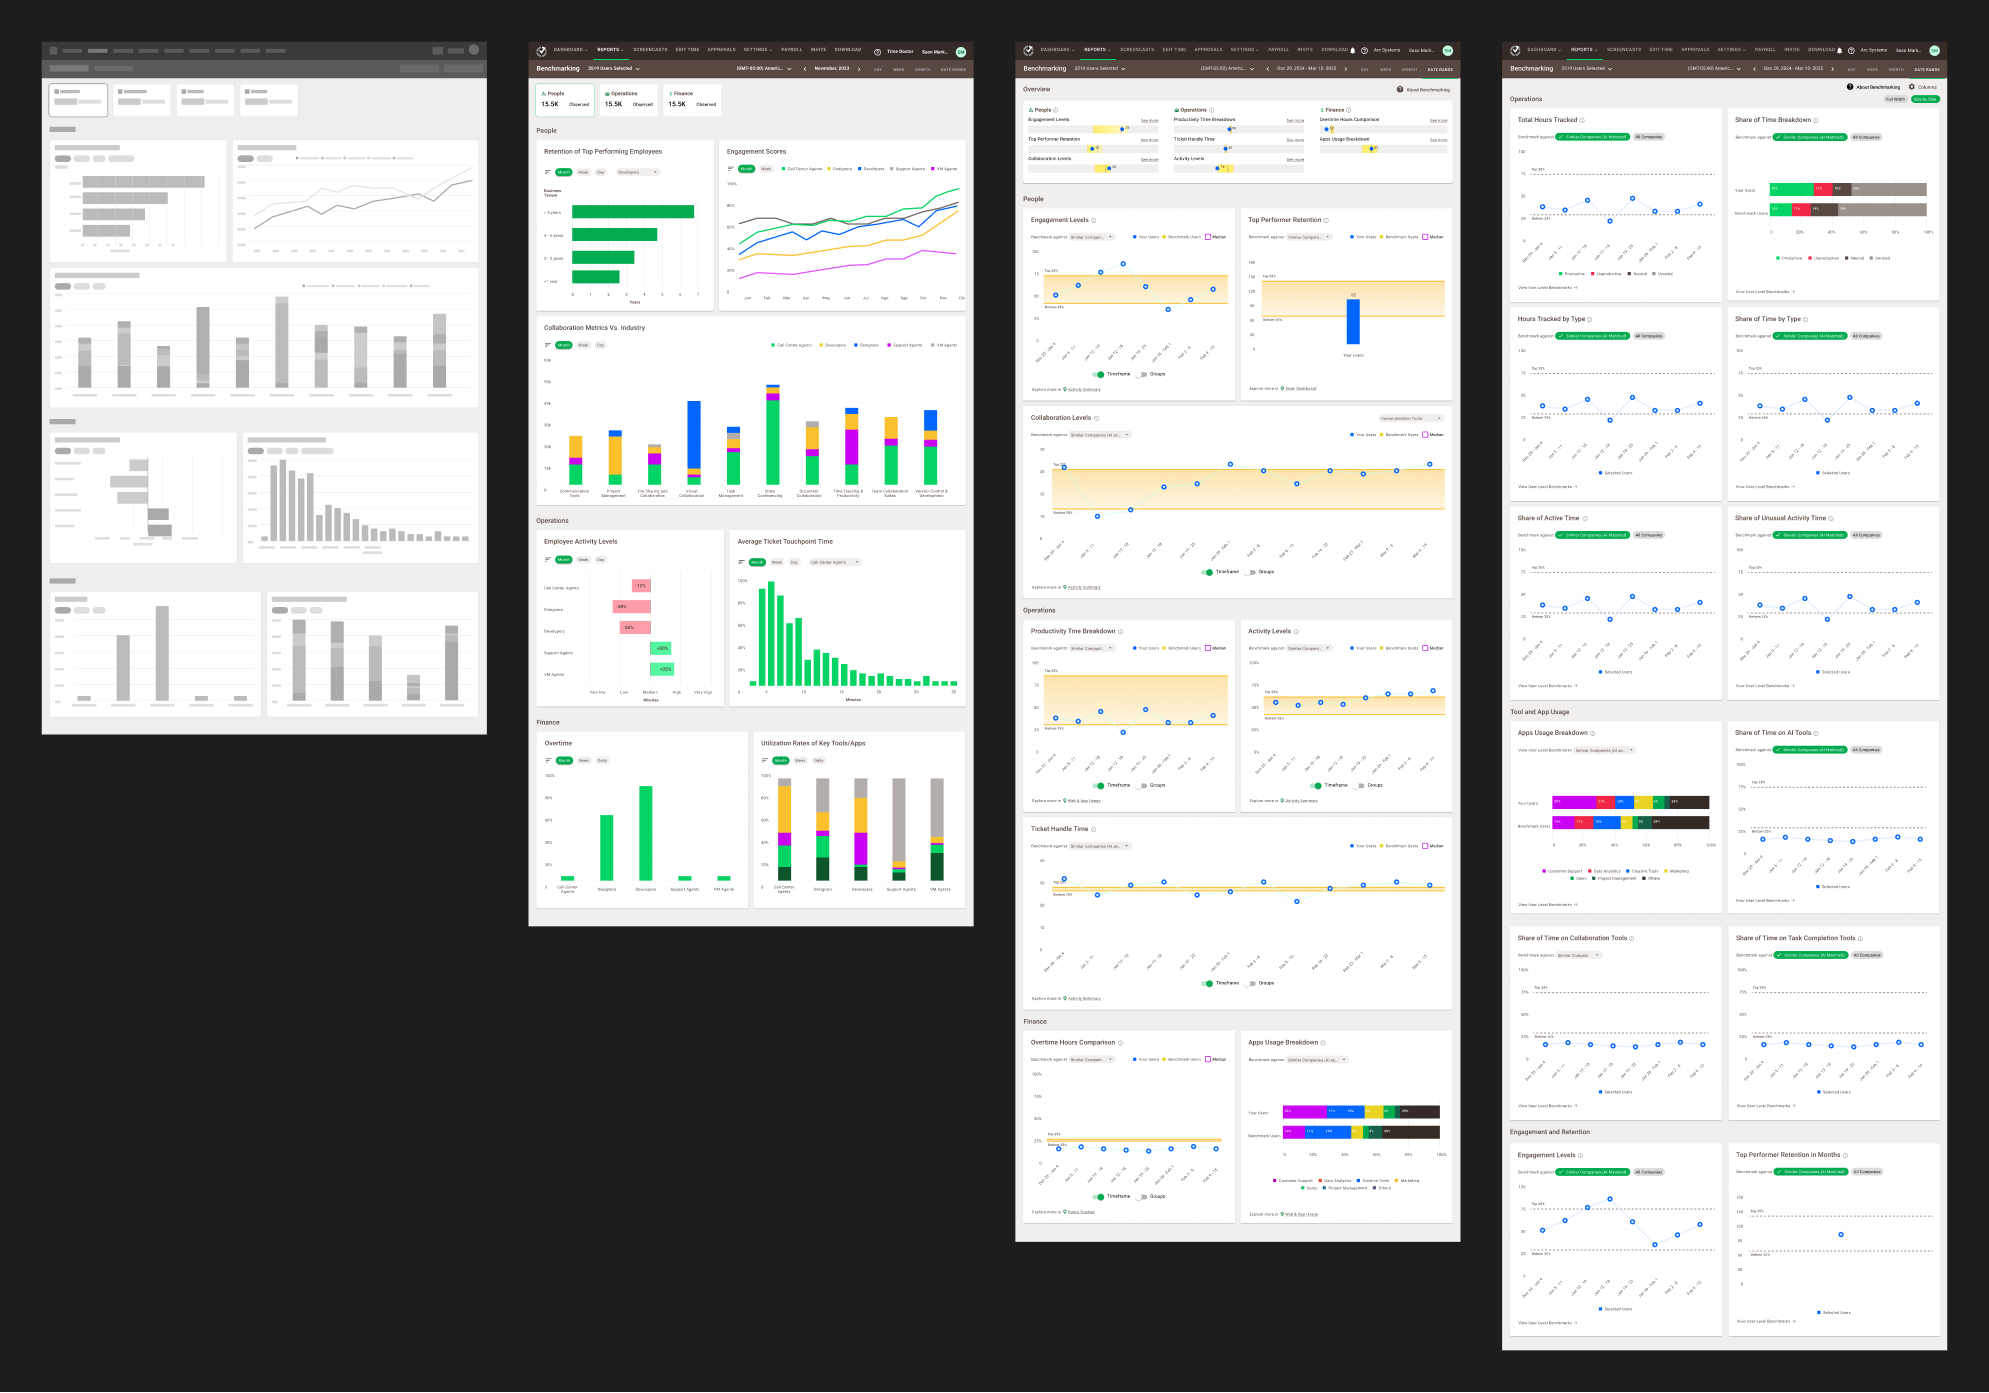
Cada ronda de pruebas cambió algo concreto: qué métricas entraron al MVP, cómo se emparejaron los gráficos, cuánto mostraba el panel lateral a la vez. Ninguna de esas decisiones sobrevivió intacta al contacto con los usuarios, y para eso se hacen las rondas.
04 · Resultado
- Lanzado públicamente dentro de Time Doctor como una nueva función de analítica.
- Adoptado por equipos internos y clientes beta para evaluaciones de desempeño y coaching.
- Validó la dirección de Workforce Intelligence, la capa de insights de próxima generación.
Benchmarks AI fue la primera pieza lanzada de un plan mucho más largo: un asesor de IA para la productividad. El MVP nunca estuvo pensado para completar esa visión. Estaba pensado para poner la versión real más pequeña de ella frente a clientes que pagan y descubrir si la idea se sostenía fuera de la presentación.
El objetivo nunca fue un dashboard terminado. Fue un detonante de conversación entre los datos, el diseño y las personas que lo usan.
05 · Reflexión
El producto dejó de tratarse de registrar el trabajo y pasó a tratarse de entenderlo.
Mi trabajo no era agregar más datos — ya había de sobra. Era darles el contexto suficiente para volverse útiles.
Benchmarks AI demostró esa dirección con la fuerza suficiente para convertirse en la base de lo que estamos construyendo ahora: Workforce Intelligence.
Todas las pantallas muestran datos de demostración · Sin información real de clientes ni de empleados